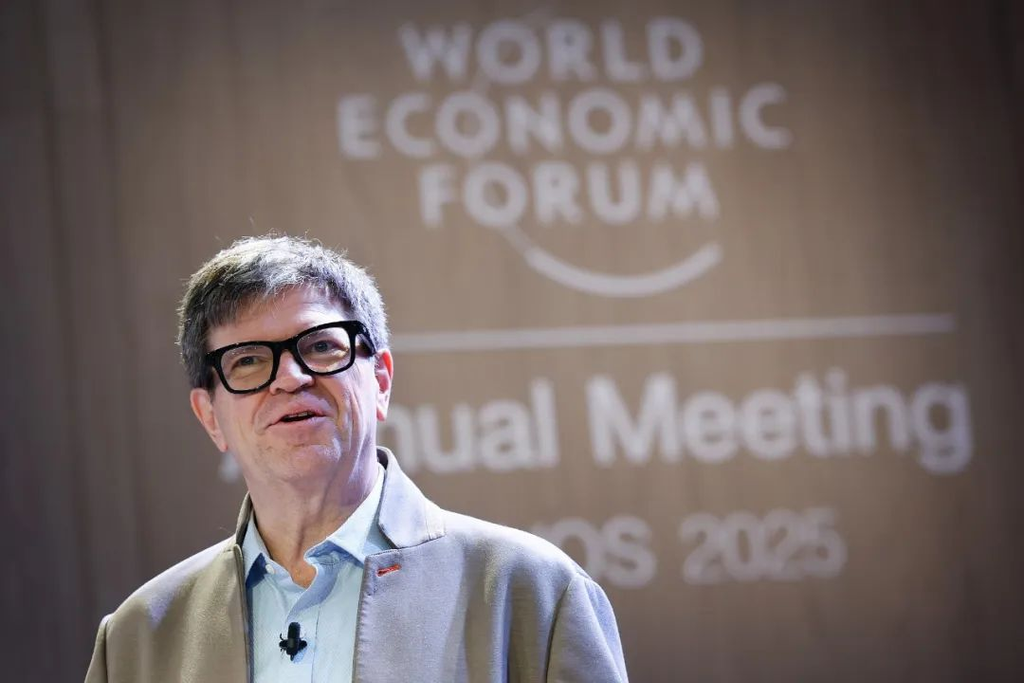
杨立昆(Yann LeCun),法国籍,1960 年出生于法国,纽约大学塔坦工程学院电气与计算机工程教授、Courant 数学科学研究所创始主任,同时担任 Meta 副总裁兼首席 AI 科学家(VP & Chief AI Scientist)。1983 年获法国国家博士,1988—1996 年任职于 AT&T 贝尔实验室,期间提出卷积网络与反向传播的关键结构;1998 年与 Hinton、Bengio 合作扩展玻尔兹曼机理论;2013 年加入 Facebook 研究院并领导 FAIR 团队;2014 年团队发表用约 6000 万参数、约 12 亿标注像素训练深度卷积网络的工作,直接推动 ImageNet 竞赛时代 CNN 的普及;2015 年与 Hinton、Bengio 在《自然》上发表《Deep learning》综述;2017 年与 Hinton、Bengio 共同获得图灵奖。
核心观点
一、深度学习的爆发不是算法的胜利,是数据、算力与算法同时到位的胜利。2009 年 ImageNet 发布时收录约 1.4 亿张带类目标注图像、覆盖约 2.1 万个类别;2012 年 AlexNet 在其上把 top-5 错误率降到 15.3%,第二名约 26.2%。杨立昆反复强调:没有这个规模的数据基础设施,卷积网络至今仍是实验室玩具。
二、卷积网络的正确性来自对生物视觉机制的借鉴,而不是数学上的优雅。他 1989 年在 NeurIPS 提出的「卷积层 + 池化 + 反向传播」结构,核心假设是视觉皮层的神经元具有局部连接与平移等变性特征;这一假设后来被无数工程实践反复验证。
三、预测下一个词的大模型不可能单独产生真正的智能。这是他 2023 年以来最激烈也最被广泛引用的判断:他认为大语言模型缺乏对世界状态、因果结构、长期记忆与行动规划建模的能力,因此无法支撑真正的自主智能体。
四、自监督学习是深度学习下一阶段的必经之路,而不是可选分支。他主张模型必须自己从数据中构造学习目标,比如 JEPA 架构让模型在抽象表征空间里预测「未来表征」而非像素,从而获得规划能力。
五、AI 的长期进步依赖开放科学与开源,而不能被少数几家封闭公司垄断。FAIR 主导的 PyTorch 1.0、CLIP(约 4 亿图文对)与 Segment Anything(约 1100 万图像、超 10 亿掩码)都是这条主张的产物;2025 年他参与创办由 Meta 资助的非营利研究机构 AMI,把这一主张推进到组织层面。
一、1989 年那张论文:一个从生物大脑里「抄」来的结构
1978—1983 年,杨立昆在 ESIEE Paris 读电子工程,随后取得法国国家博士学位——论文主题正是卷积网络及其计算性质。1985—1988 年,他在多伦多大学做博士后,与 Geoffrey Hinton 等人合作,这段时间正是他日后重回深度学习核心圈子的最初纽带。
1988 年他进入 AT&T 贝尔实验室,一待就是八年。这八年里,他 1989 年在 NeurIPS 发表的《Generalizing and Backpropagating to Applications》,首次把卷积层、池化与反向传播组合成一套可训练的架构,也就是后来被称为 LeNet 的雏形;1998 年,他与 Yoshua Bengio、Geoffrey Hinton 合作发表玻尔兹曼机学习算法的扩展工作。
值得强调的是这套架构的来源:杨立昆当时相信大脑的视觉皮层并不是逐像素存储图像的,其神经元应当具有局部连接性和平移不变性。于是他用「局部感受野 + 共享权重 + 降采样」把这三个假设写进了网络结构。1998 年 LeNet-5 在手写数字识别上的成功,让这个结构在学术圈之外有了一点名气;而在工程界真正等来大规模算力与数据之前,它沉睡了近二十年。
二、2009—2012:ImageNet、AlexNet,以及那 26.2% 与 15.3% 之间的一年
2009 年 CVPR 上发布的 ImageNet 论文题为《ImageNet: A Large-Scale Hierarchical Image Database》,首批收录约 1.4 亿张带类目标注图像、覆盖约 2.1 万个类别,同期启动了 ILSVRC 视觉识别竞赛。2012 年,Alex Krizhevsky 等人训练的深度卷积网络把 top-5 错误率降到 15.3%,而第二名约为 26.2%——一个在今天看来不算惊人的差距,在当年却足以让整个学界意识到:深度学习不是渐进改良,而是一次范式切换。
杨立昆是这条路上的关键人物之一。2011 年他在 NeurIPS 发表的《Learning High-Level Image Features Using Small Convolutional Networks》引入了卷积特征与显著图可视化;2014 年他与 Szegedy 等人发表《Learning Deep CNNs for Image Classification with Large Datasets》,使用约 6000 万参数、约 12 亿标注像素的预训练 + 微调流程,把 CNN 在大规模视觉任务上的可行性彻底坐实。
2015 年,《自然》上发表《Deep learning》一文,由他、Hinton、Bengio 共同执笔,系统梳理图像、语音、语言领域的进展与挑战。这篇文章后来成为深度学习复兴史上被引用最多的综述之一。也正是从这一时期开始,杨立昆的位置从「卷积网络发明者」转变为「深度学习技术路线守门人」——这是理解他后来所有争议的起点。
三、2013—2018:FAIR、PyTorch,和「开放」这个词的重量
2013 年,Facebook 收购成立 FAIR(Facebook AI Research),杨立昆任主任。2014 年,FAIR 发表《Learning Deep Features for Discriminative Localization》,让卷积网络不仅能分类,还能定位物体在哪;2015 年他与同事在 CVPR 发表《Deep Inside Convolutional Networks》,系统讨论了类 CNN 的可解释性方法。
2016 年,FAIR 向开发者发布 Torch 深度学习框架;2018 年开源 PyTorch 1.0。PyTorch 的设计强调灵活性与研究效率,此后成为全球深度学习研究与教学的事实标准之一。当一个国家的 AI 人才密度取决于能否自由使用最好的工具时,PyTorch 的分量就远不只是一个框架的份额。
2017 年,杨立昆与 Hinton、Bengio 共同获得 ACM 图灵奖,表彰他们在深度学习概念与工程上的奠基性贡献。这是对「深度学习三巨头」这一称呼的正式确认——但也意味着一件事:他从这一天起,不再只是研究者,而成了这套技术体系的代言人,也成了它未来走向的公开辩护人。
四、2021—2025:从 CLIP 到 Segment Anything,再到「他说 AI 走错了路」
2020 年 FAIR 发表自监督学习相关工作;2021 年 FAIR 推出 CLIP 相关研究,论文使用约 4 亿图文对训练;2022 年 FAIR 发布 Segment Anything(SAM),论文称使用了约 1100 万张图像和超过 10 亿个掩码训练,面向通用图像分割。2024 年 Meta 发布 Llama 3,模型家族公开提供 8B 与 70B 参数版本。
但在同一段时间里,杨立昆成了 AI 行业最具争议的声音之一。他反复公开表示:仅靠预测下一个 token 的大语言模型,不可能在原理上产生真正的智能,因为它们既没有对世界状态的理解,也没有对物理因果的建模,更没有能在长时间尺度上做规划的机制。他主张的方向是「世界模型」与「能量模型」——让系统学习世界状态的抽象表征,并在这个表征空间里做预测与规划。
2023 年,FAIR 发表 JEPA 系列工作,核心思路是让模型在表征空间而非像素空间做预测,从而绕开「预测像素太难、也不重要」这一困境。2025 年,他参与创办 Advanced Machine Intelligence Institute(AMI)——一家由 Meta 资助的独立非营利 AI 研究机构,定位是开放、协作、面向科学发现的 AI 研发组织。
在一次公开访谈中,他被问到是否看好大模型路线时,给出了一个相当直接的回答:他把今天的 LLM 比作「在人类语言的统计结构上做压缩」,认为压缩本身不理解它压缩的东西。这是他的核心命题,也是他此后所有争论的原点。
五、他真正反对的是什么:一场关于「智能定义权」的争夺
理解杨立昆的争议,关键是区分他反对什么、他不反对什么。他不反对深度学习——他本人是这一技术的主要发明者之一;他不反对大模型的工程价值——他领导下的 FAIR 在数据和开源模型上的贡献有目共睹。他反对的是一种具体的观点:认为只要把语言模型做得足够大、喂足够多的数据,通用智能就会自然涌现。
他的论证路径是:智能的核心能力是预测世界状态、制定长期计划、在抽象空间里做因果推理;而语言模型训练的是「给定前文预测下一个 token」,这个目标里既没有物理世界,也没有行动后果。一个不能预测「我推倒这杯水会发生什么」的系统,无论语言多流畅,都不具备自主性。
这套论证的学术价值极高,但它在产业时间表上提出了一个尖锐的问题:如果世界模型是必经之路,那么以当前算力规模和工程节奏投入的资本,是否可能在两三年内被技术路线切换所摊薄?这正是资本市场对「首席 AI 科学家出走」与「开源实验室被 Meta 资助」这类消息反应强烈的原因。
六、一个法国人在美国的三十年,以及他留下的两份遗产
2024 年 5 月,纽约大学宣布授予杨立昆「纽约大学 特聘教授」荣衔,以表彰他在纽约大学数据科学研究所(由他从 2013 年起担任创始主任)期间的贡献。2025 年,他与 Meta 及合作伙伴共同推动 AMI 的落地,公开身份为 Meta 副总裁兼首席 AI 科学家、纽约大学教授、2017 年图灵奖得主。
回望他的轨迹:1960 年出生于法国,1983 年获国家博士,1988 年到贝尔实验室,1995 年加入 NYU,2013 年进入 Facebook,2017 年获图灵奖,2025 年参与创办一家非营利研究机构——他把大半生用在了把一个「不够工程、不够大规模」的思路,坚持成了一整套可用的技术栈。卷积网络、PyTorch、CLIP、SAM、JEPA,五代工作跨越三十年,每一代都在回答同一个问题:机器怎么看见、怎么理解。
而他今天抛出的新问题——智能到底需不需要理解世界——或许正是他留给下一个十年的那道题。对中国企业而言,这道题同样具体:当所有人都在把大模型参数往更大推的时候,一个来自 AT&T 贝尔实验室的法国人一直在提醒:能预测语言的系统,和能行动的智能之间,还隔着一整个范式。