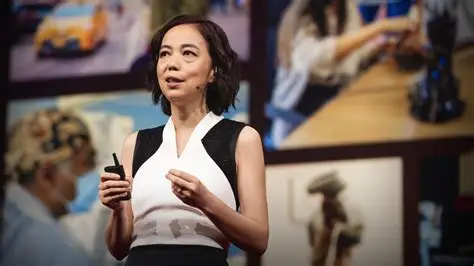
李飞飞(Fei-Fei Li),World Labs 联合创始人兼首席执行官、Stanford University 计算机科学教授、Stanford HAI(以人为中心的 AI 研究院)联合主任。1976 年出生于北京,成长于成都,1999 年赴美进入 Princeton,2003 年获电气工程学士与计算机科学辅修学位,2009 年获加州理工学院电气工程博士学位,2006 年在 Caltech 开启大规模数据集研究,2009 年主导发布 ImageNet 并启动 ILSVRC 视觉识别挑战赛,2014 年加入 Google 研究院,2017 年在《自然》发表《How AI could empower any business》并发起 AI4ALL,2018 年推动成立 Stanford HAI 并任联合主任,2024 年从 Google 离职创办 World Labs。
核心观点
一、AI 的突破是数据基础设施的突破,模型只是最后一步。2009 年的 ImageNet 收录约 1.4 亿张带类目标注图像、覆盖约 2.1 万个类别;正是这个规模让 2012 年 AlexNet 的 top-5 错误率从 26.2% 降到 15.3%,让整个领域意识到深度学习不是改良而是换赛道。
二、智能的创造者不是研究者,是那 14 亿张图片背后的标注人力。李飞飞反复指出,ImageNet 的关键不是算法,而是十余万人完成的类别标注与边界框标注;她把这支劳动队伍称为「揭示我们如何借助工具感知世界的人」。
三、AI 应该是以人为本的,而不是把人当作要被优化的参数。从 2018 年 Stanford HAI 的成立框架,到《以人为中心的 AI 政策框架》,她坚持把公平、隐私、权利与社会后果放在模型的性能之前。
四、空间智能是下一代 AI 的关键,模型不能只识别像素。2024 年 World Labs 的首篇研究提出从互联网视频与 3D 交互数据中学习「空间智能」——让模型理解物体的形状、位置、遮挡与因果,并生成可交互、可探索的三维世界。
五、AI 治理不能只由少数技术和金融中心定义。2023 年起,她在联合国、达沃斯与美国国会等多个场合推动全球南方参与制定 AI 规则,主张技术进步必须回答分配与公平问题,而不只是能力问题。
一、1976—2009:移民女儿、Princeton 女生,和一个「数据」的念头
李飞飞 1976 年出生于北京,在成都长大,1999 年赴美进入 Princeton University,2003 年获电气工程学士和计算机科学辅修学位,随后进入 California Institute of Technology,2009 年获电气工程博士学位。
她的学术转向发生在 2006 年。当时的计算机视觉研究陷在一个尴尬处境:算法足够先进,但可用的标注数据太少。李飞飞在 2010 年 CVPR 论文《What is an object in 10,000 images?》中提出用众包标注分析物体的边界、视角与姿态,其背后的方法论是——不要相信研究者的判断力,要相信大规模众包的判断力。
2006—2009 年,她带领团队在 Mechanical Turk 平台上组织标注队伍,对近 50 万张图像做了类别、边界框与姿态标注。这支队伍随后扩展到十余万人。李飞飞在后来的表述中反复回到这个事实:ImageNet 的真正创新不在卷积网络,在数据生产方式本身。
2009 年 CVPR 上,论文《ImageNet: A Large-Scale Hierarchical Image Database》正式发布,首批约 1.4 亿张带类目标注图像、覆盖约 2.1 万个类别;同年 ImageNet 识别挑战赛启动。2012 年 AlexNet 在其上把 top-5 错误率降至 15.3%(第二名约 26.2%),深度学习的引爆点由此形成。那支众包标注队伍与那批 GPU 一样,是这次革命的另一半发动机。
二、2014—2017:在 Google 内部,看到「AI 能做什么」和「AI 应该做什么」
2014 年,李飞飞加入 Google 任 Research Scientist,进入 Google Brain 相关研究体系。她的研究风格延续了此前的路径:2014 年发表《Learning Deep Features for Discriminative Localization》,推动卷积特征的可视化与定位;2015 年在 CVPR 发表《Deep Inside Convolutional Networks》,系统讨论类 CNN 模型的可解释性与显著图;2016 年发表《A New Deep Learning Model for Image Recognition》,介绍 Inception/GoogLeNet 的多尺度迁移学习思路;2017 年参与发表《Rethinking the Inception Architecture for Computer Vision》,即 Inception-v3。
但在 Google 内部,她越来越把重心从「模型能做什么」转向「技术应该服务谁」。2017 年,她在《自然》发表《How AI could empower any business》,核心判断是 AI 正从专家领域向普通行业扩散——她举的例子不是自动驾驶,而是小商户、医护人员与教育资源匮乏地区。
同一年,她发起 AI4ALL,目标是扩大 AI 教育机会。2018 年,她推动成立 Stanford HAI 并出任联合主任,明确把「以人为本」写进研究院的建院原则:不是先造最强的模型再补伦理,而是从人的需求出发去设计研究议程。
三、2019—2023:把 ImageNet 变成基础设施,把 AI 治理带上全球舞台
2019 年,《ImageNet: The Large-Scale Image Database in Computer Vision》在《自然》正式发表,论文给出完整的 ImageNet 数据集口径:超过 1400 万张带边界框标注图像、约 2 万个类别,训练集约 1,282,267 张、验证集 5 万张、测试集 10 万张。这篇论文让 ImageNet 从一个竞赛数据集变成了一项可以长期引用的公共基础设施。
同年,Stanford HAI 发布《The Ethics of AI》等研究政策活动,把公平、隐私与可解释性推到研究议程前沿;2020 年,Stanford 公布《A Policy Framework for Human-Centered AI》,为以人为中心的 AI 治理提供了框架化路径。
2021 年前后,COVID-19 期间的视觉检测技术应用让 HAI 的研究进入公共视野。而在全球治理层面,李飞飞的注意力从模型移到了规则:2023 年起,她在联合国、达沃斯论坛与美国国会等场合持续发声,推动 Global AI for Good Governance 相关倡议,核心主张是——AI 规则的制定权不应只掌握在少数技术与金融中心手里,全球南方必须参与其中。
四、2024:从 Google 离职,创办 World Labs,追一个「空间智能」的赌注
2022 年,李飞飞出版英文著作《The Worlds I See》,中文版常译《我看见的世界》,把个人移民经历、AI 伦理与「两种世界观」的碰撞写在一起。2024 年,她从 Google 离职,联合创立 World Labs。
同年 9 月,World Labs 发布首篇研究博客《Generative Models of Spatial Intelligence》,提出从互联网视频与 3D 交互数据中学习「空间智能」的路线。核心主张很清晰:现有的视觉模型擅长分类与描述,但并不真正理解物体在三维空间中的形状、位置、遮挡关系与物理因果;而下一代 AI ——尤其是具身智能与机器人 ——必须具备这种能力。
她在接受采访时给了一个更朴素的解释:人类婴儿并不认识任何标签,就能在没有任何文字标注的情况下通过少量感官输入理解「杯子」「球」「空间」,并预测「如果我推开它,它会往后移动」。而今天的模型要理解一个概念,需要数百万张人工标注的图片。「AI 不该只在人类已经标好的世界里学习,它应该在没有标签的物理世界里自己学。」
2025 年,World Labs 继续推进其空间智能模型的研究与产品化,媒体报道的融资与估值区间差异很大,官方并未完整披露相关条款,因此具体数字仍需以公司披露为准。但方向已经清晰:从「看懂图像」走向「理解空间」。
五、李飞飞与她的同行们不一样在哪里:把「人」写进技术路线
与一批从算法或架构出发往上做产品的研究者不同,李飞飞的路径始终是「先看清楚问题出在社会哪一层,再决定用什么技术」。她 2006 年那个用众包绕开数据瓶颈的决定、2017 年那篇讨论 AI 赋能普通企业的文章、2018 年把伦理写进研究院建院原则、2023 年推动全球南方参与 AI 治理——这是同一条线索的四个节点。
她的批评也常常在同一个方向上。2018 年前后,她公开质疑以「公开发表影响」为主要评价标准的 AI 学术激励结构,认为这会诱导研究者去追逐更有噱头的话题而非更基础的问题;她也批评把 AI 能力差距简单归因于「人才储备」的论调,认为更关键的是数据、算力与研究资源的结构性分配。
值得强调的是,这种「先看系统再看模型」的方法论,恰恰也是她做 ImageNet 时用过的方法论——识别真正的瓶颈(数据),组织资源绕开它(众包),然后把成果公共化(数据集永久开放)。她在 World Labs 做的空间智能,仍是同一套方法论在下一个瓶颈上的应用。
六、她留下的东西:一个数据集、一个研究院,和一个还没被证实的问题
2019 年 Nature 论文中,ImageNet 的规模被固定为一个可引用的坐标:超过 1400 万张带边界框标注图像、约 2 万个类别,训练集约 128 万张。2012 年那个 15.3% 的数字之所以重要,正是因为它出现在这张坐标图上——它证明了在足够大的数据上,算法可以跨过一条此前被认为不可跨越的线。
李飞飞留下的三样东西因此是连贯的:一个可被所有人复用的数据集(ImageNet)、一个把伦理写进建院原则的研究机构(Stanford HAI)、以及一个尚未被证实但足够具体的研究命题(空间智能与 World Labs)。前两样已经被证明耐久,第三样还在被证明。
从北京到成都,从 Princeton 到 Caltech、从 Stanford 到 Google,再到从 Google 到 World Labs——她用二十年时间反复验证一个判断:技术进步的方向,最终由那些被技术影响最深的人来定义,而不是由最先把技术做出来的人。这也是一个中国移民科学家在美国 AI 体系中最难被复制、也最难被忽略的位置。